Zweiter Deep-Dive: was AI 2026 wirklich kann, und was nicht.
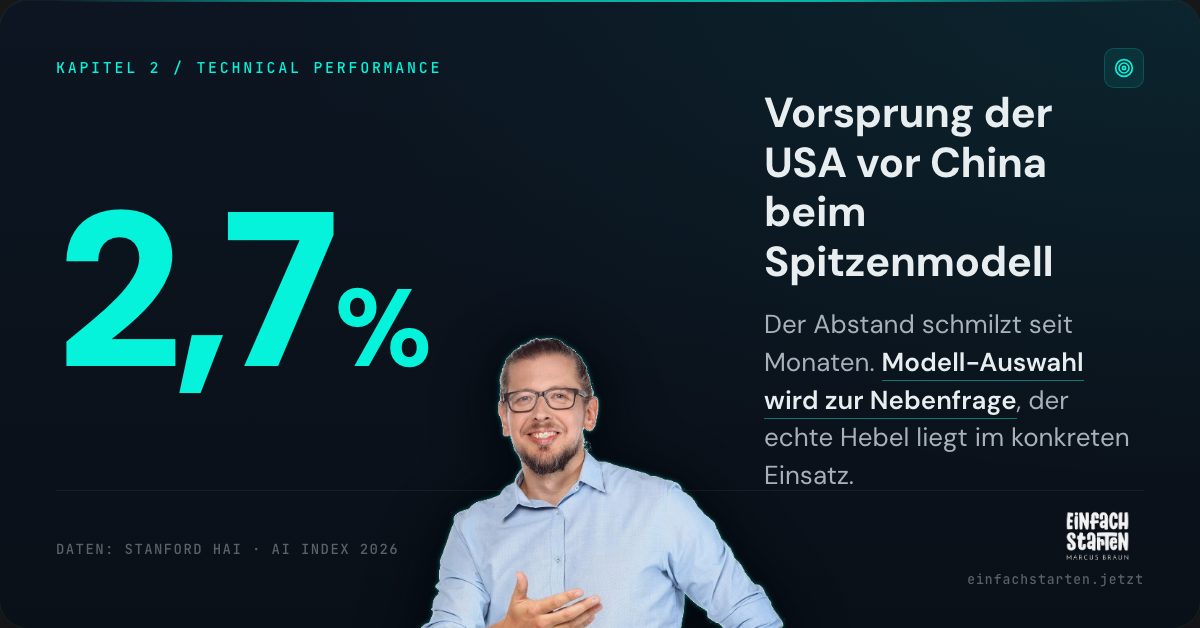
AI hat 2025 einen großen Sprung gemacht. Bei einem strengen Test für Software-Entwicklung ist die Trefferquote in einem Jahr von 60 Prozent auf fast 100 Prozent gestiegen. AI hat eine Goldmedaille bei der Mathematik-Olympiade geholt. Die vier führenden Modelle der Welt sind nach Punktebewertung praktisch gleich gut. Der Vorsprung der USA vor China liegt nur noch bei 2,7 Prozent.
Gleichzeitig zeigen sich klare Schwächen. Roboter schaffen 88 Prozent typischer Haushaltsaufgaben nicht. Das beste Modell liest analoge Uhren nur zu 50 Prozent richtig, ein Mensch zu 90. AI-Agenten verfehlen jedes dritte Ergebnis bei strukturierten Aufgaben. Stanford nennt diese Verteilung die jagged frontier, also Spitzenleistung direkt neben Versagen, ohne erkennbares Muster.
Was das im Alltag bedeutet: Wer AI einsetzt, muss sie für den eigenen Anwendungsfall testen. Allgemeine Tests sagen wenig über die konkrete Eignung. Die Frage "welches Modell soll ich einkaufen" verliert an Gewicht, weil die Anbieter sich kaum noch unterscheiden. Wichtiger werden Kosten, Verlässlichkeit im echten Einsatz und die Anpassung an die eigene Branche.
Nächster Deep-Dive in einer Woche, dann zum Kapitel Responsible AI.
Zuerst erschienen auf LinkedIn.
Zurück: 50,6% Genauigkeit beim Ablesen analoger Uhren Alle Teile der Serie Weiter: 22-94 Hallucination-Range über 26 Top-Modelle