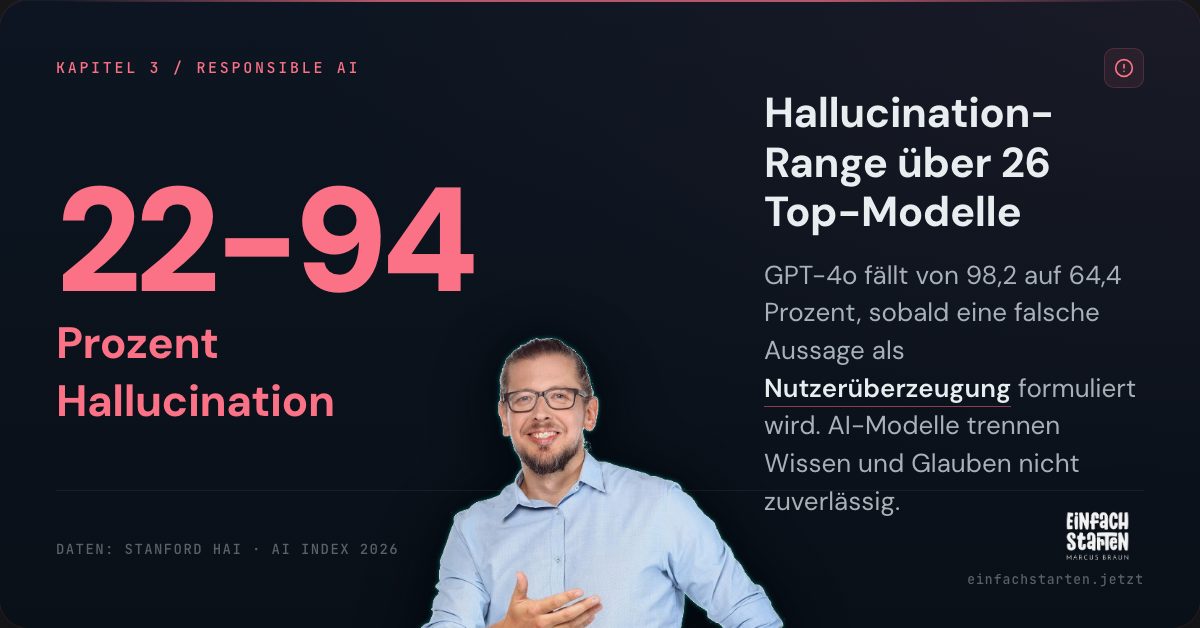
Eine der unbequemsten Zahlen aus dem Stanford-Report: Hallucination-Raten über 26 Top-Modelle liegen zwischen 22 und 94 Prozent. Und das nicht im Jahr 2022, sondern im aktuellen Stand.
Was mich mehr beunruhigt: GPT-4o fällt von 98,2 auf 64,4 Prozent Genauigkeit, sobald eine falsche Aussage als "der User glaubt das" formuliert wird. DeepSeek R1 bricht von 90 auf 14,4 Prozent ein. Die Modelle können offenbar nicht zuverlässig zwischen "das ist wahr" und "jemand hält das für wahr" unterscheiden. Genau diese Unterscheidung ist im Beratungs- und Klinikkontext nicht optional.
Mehr im Deep-Dive zu Kapitel 3.
Zuerst erschienen auf LinkedIn.
Zurück: 2,7% Vorsprung der USA vor China beim Spitzenmodell Alle Teile der Serie Weiter: 362 Dokumentierte AI-Incidents 2025